
🎬 Assista esta matéria
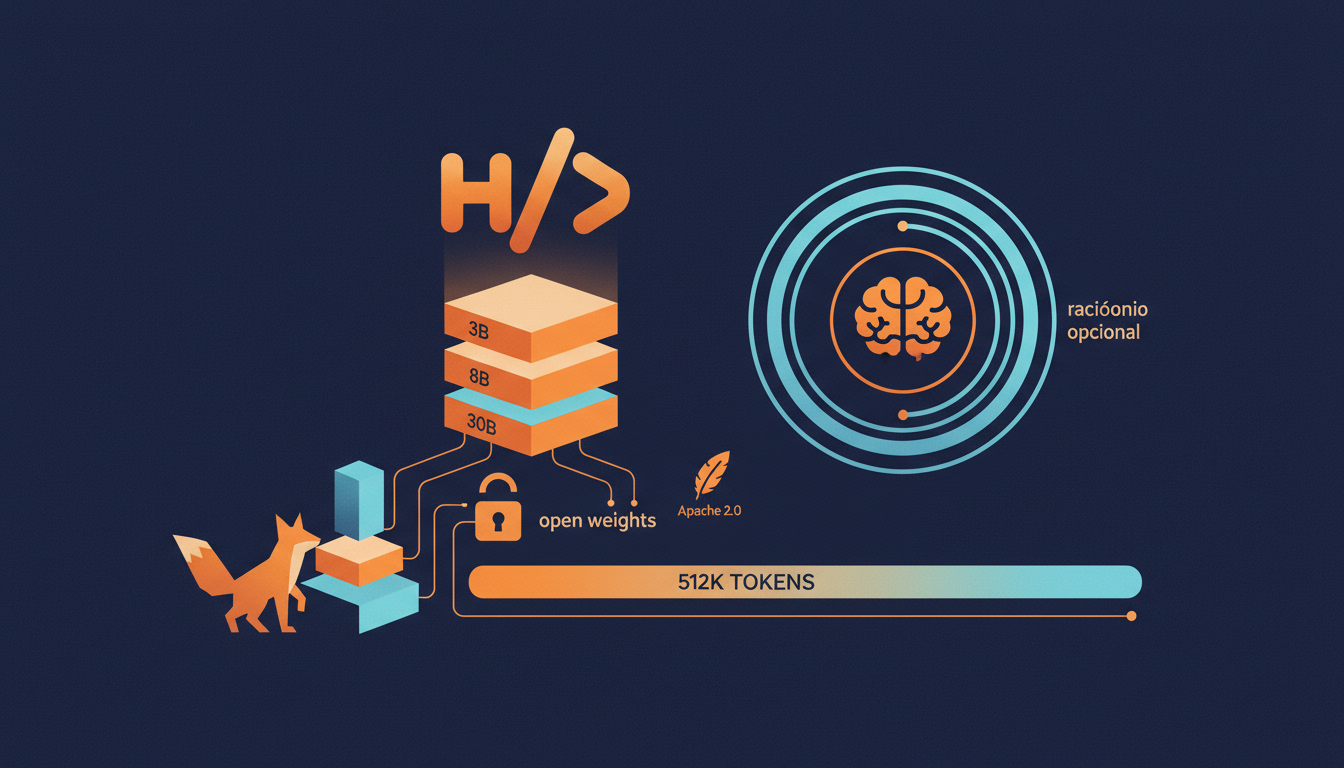
A IBM publicou em 25 de agosto de 2026 a família Granite 4.2, com pesos abertos sob licença Apache 2.0. São três tamanhos — 3 bilhões, 8 bilhões e 30 bilhões de parâmetros — distribuídos no Hugging Face, no Ollama e no GitHub, sem custo de download.
A licença permissiva é o ponto prático mais importante para quem desenvolve. Apache 2.0 autoriza uso comercial, modificação e redistribuição sem as restrições de aceitação de termos que acompanham várias famílias de modelos ditos abertos.
Raciocínio com chave liga-desliga
O diferencial da versão 4.2 é a arquitetura com um único checkpoint capaz de operar em dois modos. O modelo pode raciocinar passo a passo antes de responder ou ir direto à resposta, conforme a complexidade da tarefa. Há ainda um modo de baixo esforço para consultas simples.
Na prática, isso evita manter dois modelos diferentes em produção e reduz o gasto de computação em perguntas triviais, que hoje frequentemente consomem centenas de tokens de raciocínio desnecessário.
São modelos densos, do tipo decoder-only, treinados do zero com cerca de 15 trilhões de tokens. A janela de contexto chega a 512 mil tokens.
Treino agêntico nas versões maiores
As variantes de 8B e 30B passaram por aprendizado por reforço agêntico, ou seja, foram treinadas dentro de ambientes de execução reais, onde precisavam usar ferramentas, escrever e rodar código e fazer buscas na web para concluir tarefas. Segundo a IBM, o modelo de 30B lidera os testes de uso de ferramentas e tarefas agênticas entre modelos abertos de porte comparável.
Todos os modelos suportam chamada de ferramentas no formato da API da OpenAI, o que reduz o trabalho de migração para quem já tem código escrito nesse padrão. A execução é compatível com vLLM e SGLang.
A IBM lançou junto os modelos de fala Granite Speech 5.0 Turbo CTC, de 470 milhões de parâmetros. A empresa afirma que eles são duas vezes mais rápidos que os líderes anteriores do Open ASR Leaderboard e conseguem transcrever três horas de áudio em um segundo.
Para quem serve
O posicionamento é claramente corporativo e local. Os tamanhos escolhidos cabem em uma GPU única ou até em hardware de mesa, no caso do 3B, o que atende empresas que não podem enviar dados para APIs externas por razões regulatórias — cenário comum em setores financeiro, jurídico e de saúde.
Fontes: The Decoder · MarkTechPost · The New Stack
🎙️ Gostou? Receba só o que te interessa, todo dia
Escolha seus temas e receba um briefing diário em áudio e texto, de graça, no WhatsApp ou e-mail.
Montar meu briefing grátis